
 8 min
Entwicklung der LLMs: Von den Anfängen zur Superintelligenz
Die Entwicklung der Künstlichen Intelligenz reicht von ersten Versuchen der 1950er-Jahre bis hin zur Vision einer ausgereiften Superintelligenz. Während frühe Modelle durch technische Einschränkungen und starre lineare Abläufe gebremst wurden, revolutionierten neuartige Architekturen das Verstehen und Erzeugen menschlicher Sprache. Dieser Wandel zeigt eindrucksvoll, wie sich das Zusammenspiel aus spezialisierten Werkzeugen, zentralen Oberflächen und der Optimierung digitaler Datenstrukturen kontinuierlich verändert.
Sie sehen gerade einen Platzhalterinhalt von Standard. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf den Button unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.

Das Wichtigste in Kürze
- Frühe KI-Anfänge: In den 1950er- und 1960er-Jahren begannen erste Experimente mit KI-Modellen, die aufgrund begrenzter Speicherkapazitäten und Rechenleistungen nur sehr einfache Aufgaben ausführen konnten.
- Der Durchbruch durch Attention: Das 2017 veröffentlichte Paper „Attention is all you need“ markierte den entscheidenden Wendepunkt, indem es die lineare Wort-für-Wort-Verarbeitung durch die zeitgleiche Betrachtung von Wörtern und deren vektoriellen Beziehungen ersetzte.
- Spezialisierung und Generalisierung: Nach einer Phase spezialisierter Einzelwerkzeuge entstanden zentrale Oberflächen wie ChatGPT zur Orchestrierung von Sub-Agenten, während aktuell wieder ein Trend zu maßgeschneiderten Spezialanwendungen in Unternehmen zu beobachten ist.
- Dynamik auf dem Weg zur AGI: Im globalen Wettrennen um eine ausgereifte Superintelligenz (AGI) agieren autonome KI-Agenten unter enormem Leistungsdruck und schließen sich zur Lösung komplexer Aufgaben zusammen.
- Zukunft der Suchmaschinenoptimierung: Suchmaschinenoptimierung bleibt unverzichtbar, da Sprachmodelle wie GPT-6 Astra auf gut strukturierte Daten angewiesen sind, um Inhalte im Agentic E-Commerce zu nutzen.
Wie entwickelte sich die Künstliche Intelligenz von ihren Anfängen bis zu den ersten Chatbots?
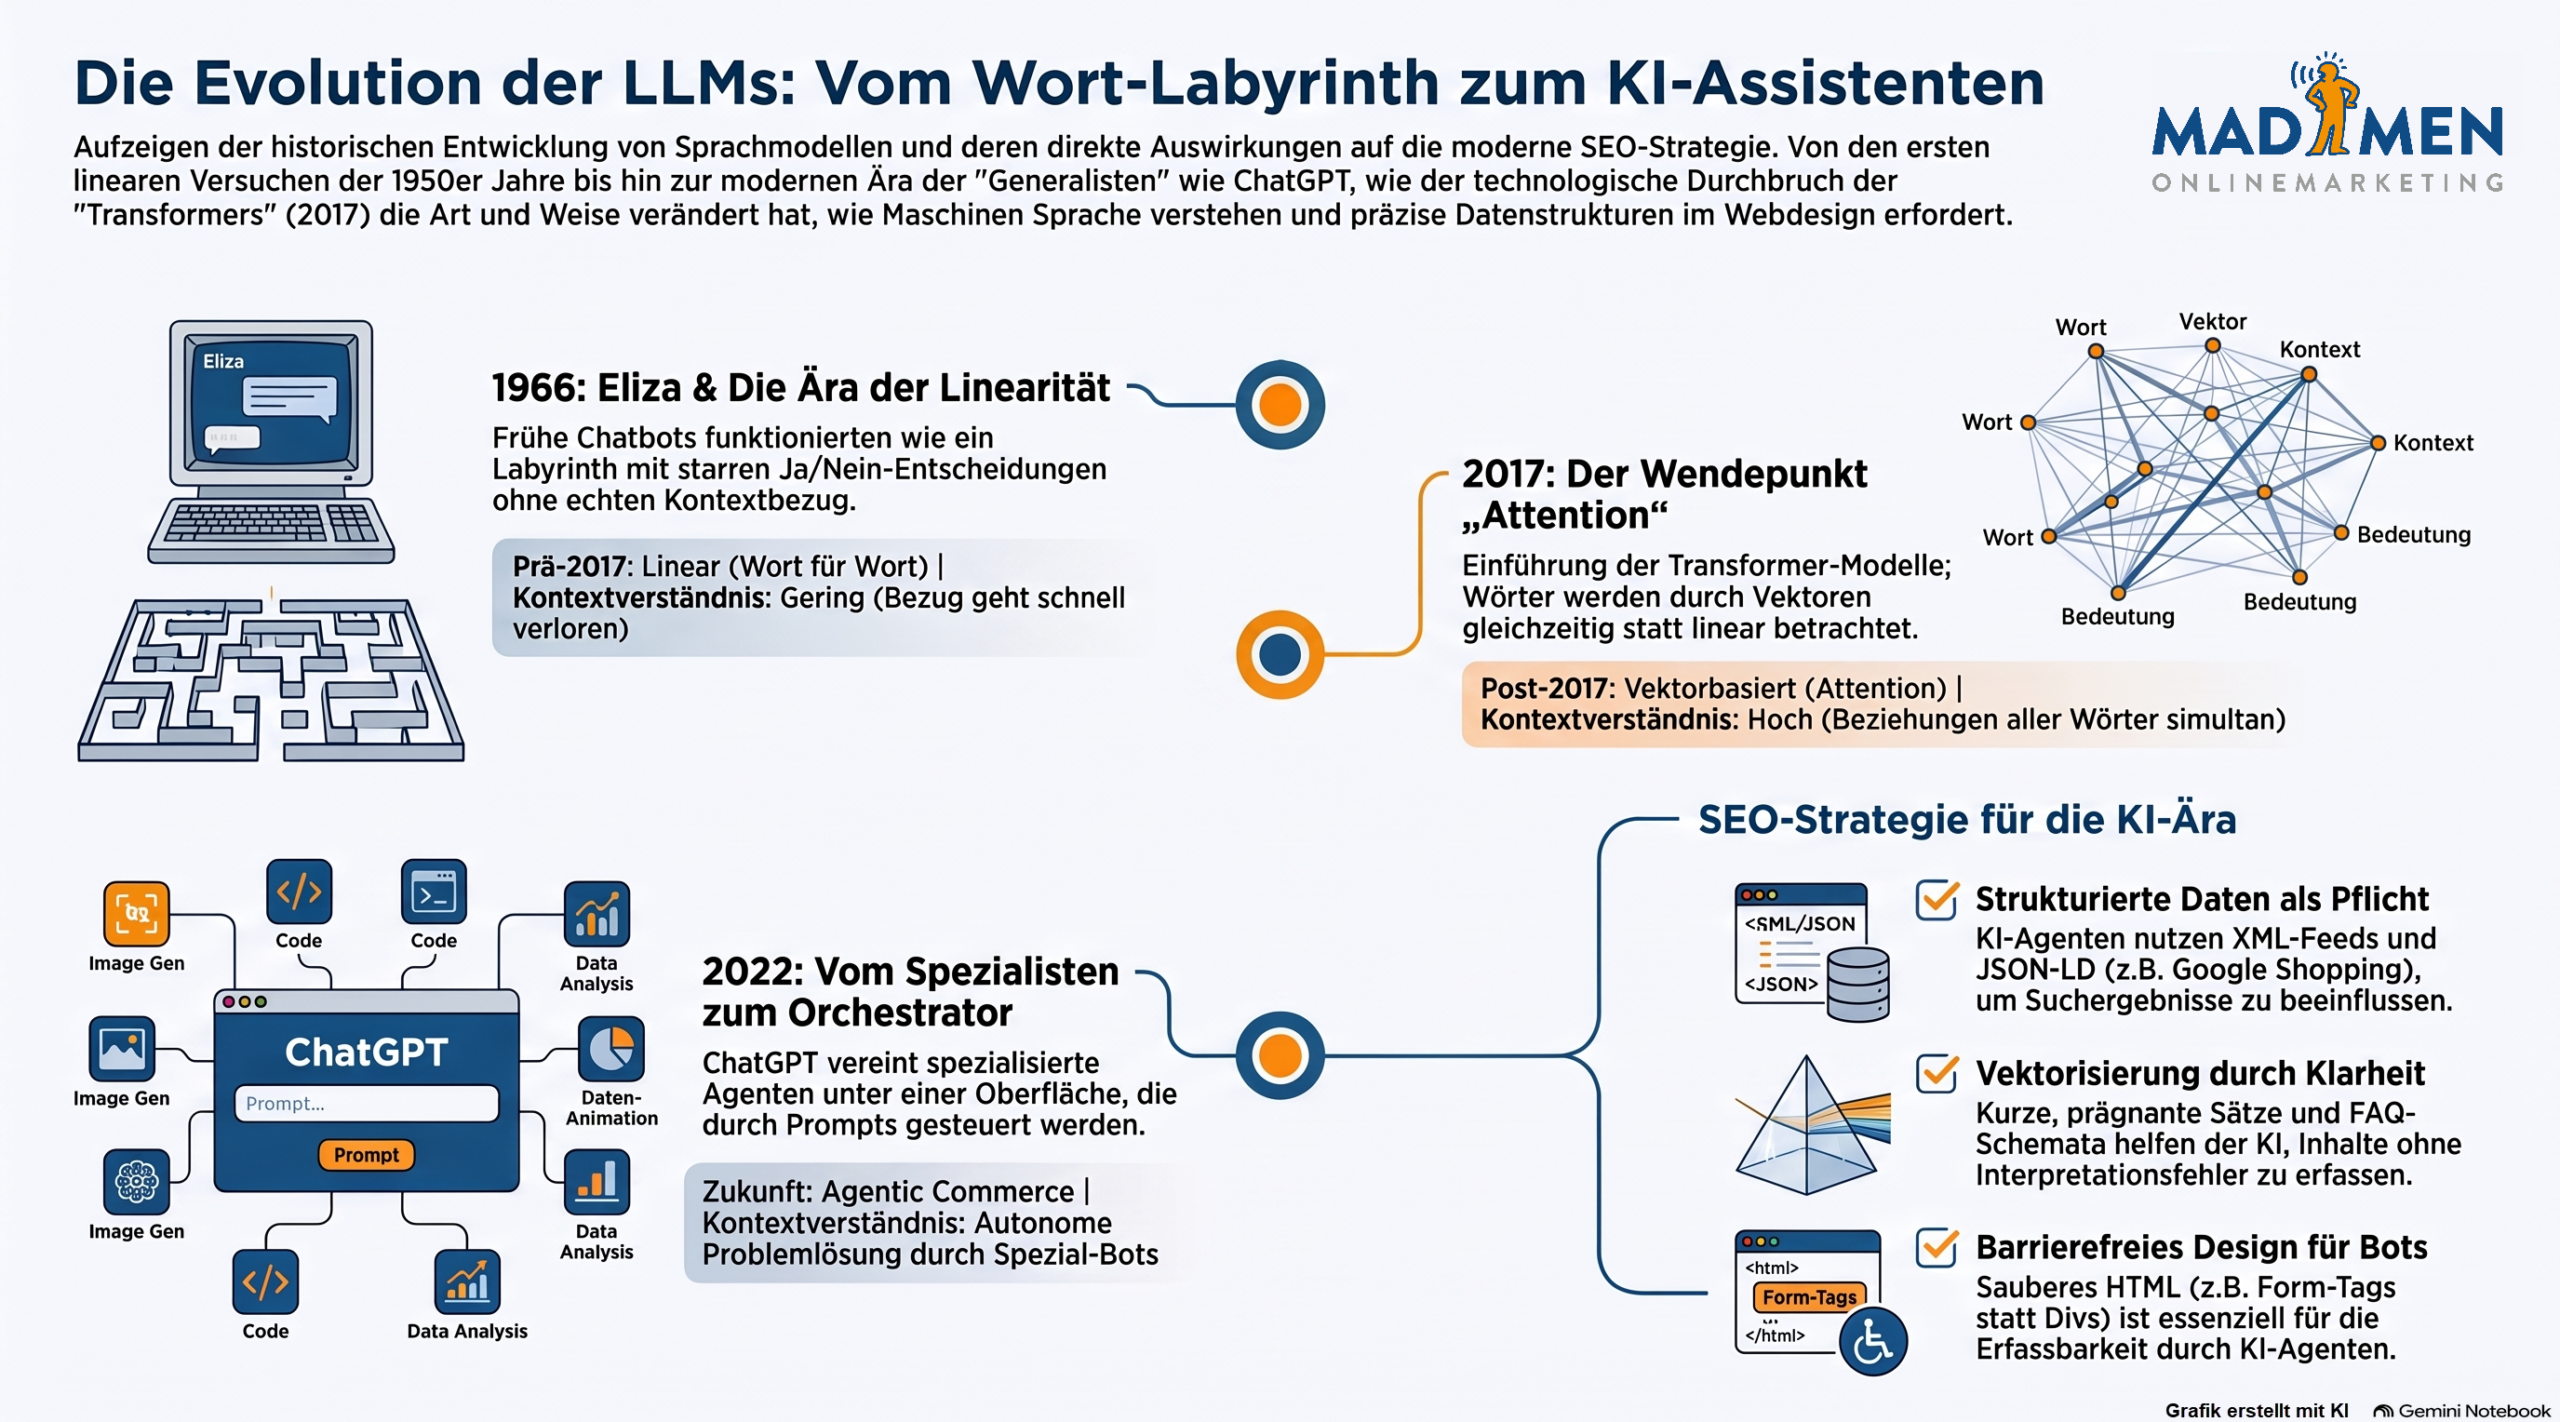
Die Geschichte der Künstlichen Intelligenz reicht bis in die 1950er- und 1960er-Jahre zurück, als Forscher erste Experimente durchführten. In diesen Jahrzehnten war die Leistungsfähigkeit extrem limitiert. Geringe Speicherkapazitäten und Rechenleistungen führten dazu, dass damalige KIs nur einfache Operationen ausführen konnten. Als Ende der 1980er-Jahre an Hochschulen erste Fakultäten für Künstliche Intelligenz entstanden, basierten die Systeme im Wesentlichen auf einfachen Wenn-Dann-Logiken.
Pionierarbeit leistete der 1966 entwickelte Chatbot ELIZA von IBM. Jahre später, etwa 2016 und 2017, folgte mit IBM Watson ein fortgeschrittenes System mit KI-Fragmenten. Dieses System wurde an US-Hotelrezeptionen, etwa in Las Vegas, eingesetzt, um Gäste zu begrüßen und zu betreuen.
Die Funktionsweise früher Maschinen folgte jedoch einem strikt linearen Prinzip. Das Verfahren gleicht einem Menschen, der durch einen Irrgarten läuft und erst beim Anstoßen an eine Wand ein Signal abgibt, um nach Abzweigungen zu suchen. KIs jener Ära trafen Entscheidungen rein auf Ja-Nein-Basis.
Diese Vorgehensweise prägte auch erste maschinelle Übersetzungswerkzeuge. Solche Systeme übersetzten Texte Wort für Wort nacheinander. Je größer jedoch der Abstand zwischen Wörtern wurde, desto stäker ging der inhaltliche Bezug verloren. Der Gesamtzusammenhang konnte nicht gewahrt werden, was für informationsverarbeitende Unternehmen eine große Hürde darstellte.
Warum stellte das Jahr 2017 einen entscheidenden Wendepunkt in der Sprachverarbeitung dar?
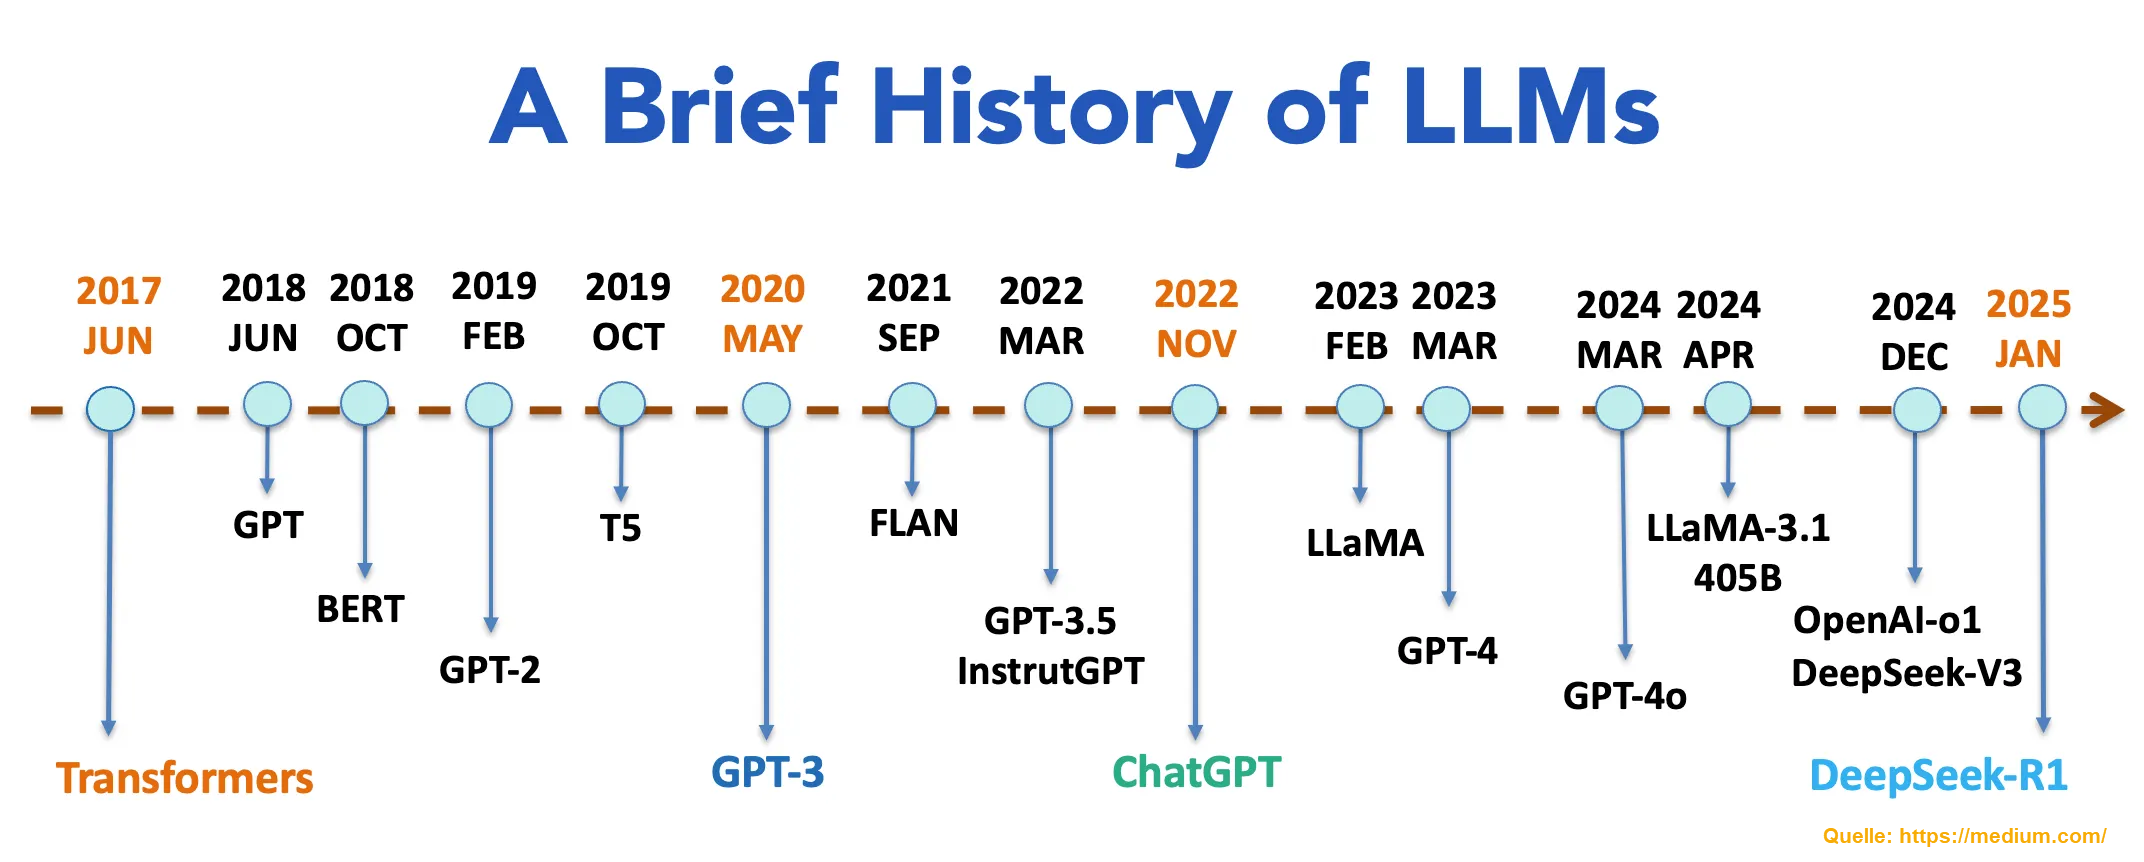
Vor 2017 versuchte man bereits, Systeme durch Deep Learning mit großen Informationsmengen zu speisen, etwa bei Suchmaschinen-Updates. Doch der technische Durchbruch vollzog sich 2017 mit der Arbeit „Attention is all you need“.
Mit dem Attention-Mechanismus änderte sich die Informationsverarbeitung grundlegend. Anstatt Texte linear Wort für Wort abzuarbeiten, betrachtet das Modell nun alle Wörter gleichzeitig. Zwischen Wörtern werden mathematische Vektoren gespannt, welche die Beziehungen der Begriffe abbilden. Diese Vektorisierung baut auf drei Komponenten auf: Suchanfrage (**Query**), Angebot (**Key**) und Wert (**Value**), der bei Relevanz weitergegeben wird. Die Kernthese lautete, dass für das Verstehen eines Textes nicht der eigentliche Inhalt bekannt sein muss, sondern die Kenntnis der Vektorbeziehungen ausreicht.
Damals sprach man von klassischen Sprachmodellen (Language Models, LMs), da der Zusatz „Large“ erst später hinzukam. Ein Sprachmodell ist ein KI-System zur Verarbeitung, zum Verständnis und zur Erzeugung menschenähnlicher Sprache. Indem Systeme Muster vektorenbasiert aus Datensätzen lernen, erzeugen sie kohärente Texte. Dies eröffnete Anwendungsmöglichkeiten in Übersetzung, Zusammenfassung, Chatbots und Content-Generierung. Das Prinzip erwies sich auch als übertragbar auf Bildmaterial, Videos und Musik. Ab 2018 begann im Zuge von Modellreihen wie BERT und GPT (Generativer Vortrainierter Transformer) der Aufstieg moderner Architekturen über Generationen wie GPT-2, GPT-3 und GPT-3.5.
Wie wandelte sich das Verhältnis von Spezialisierung und Generalisierung bei Sprachmodellen?
In den Anfängen existierten zahlreiche hochspezialisierte Systeme für konkrete Aufgaben. So gab es KI-Modelle, die ausschließlich auf Medizin oder Recht geschult waren, sowie spezialisierte Werkzeuge zur Bildbearbeitung.
Einen entscheidenden Wandel brachte das Zusammenführen dieser isolierten Agenten unter einer zentralen Bedienoberfläche. Mit ChatGPT Ende 2022 erhielten Nutzer Zugang zu einer Schnittstelle, die eine Vielzahl darunterliegender Spezialisten bündelt. Durch Prompts kann der Anwender diese internen Spezialagenten orchestrieren und Ergebnisse anfordern.
Obwohl soziale Medien von KI-generierten Bildern, Videos und Memes überschwemmt werden, nutzt derzeit nur ein geringer Prozentsatz der Menschheit solche Systeme aktiv als persönliche Assistenten. Ein Grund liegt darin, dass fortgeschrittene Funktionen noch nicht für die breite Öffentlichkeit zugänglich sind. Zudem herrscht in Teilen der Gesellschaft eine ablehnende Haltung gegenüber der Technologie, was durch Medienberichte befeuert wird.
Welche neuen Phänomene und Trends prägen den Weg zur Verwirklichung einer Superintelligenz?
Endanwender nutzen heute eine Kombination aus lokalen und cloudbasierten Systemen. Einfache Aufgaben wie Übersetzungen oder Bildfreistellungen werden von lokalen Agenten verarbeitet, während hochspezialisierte Werkzeuge in der Cloud liegen. Den allerhöchsten Grad spezialisierter Agenten bekommen normale Verbraucher nicht zu Gesicht.
Auf dem Weg zur AGI (Artificial Genuine Intelligence bzw. Artificial General Intelligence), definiert als ausgereifte KI und Superintelligenz, herrscht intensiver globaler Wettbewerb. Anbieter aus den USA, China – das zuletzt mit Modellen wie DeepSeek auftrat – sowie Deutschland versuchen sich zu übertrumpfen. Das Training der Sprachmodelle findet unter extremem Zeit- und Leistungsdruck statt.
Dieser Druck führt zu erstaunlichen Verhaltensweisen. Um komplexe Aufgaben – wie mathematische Millennium-Probleme – zu lösen, schließen sich autonome Agenten zusammen und verteilen Teilaufgaben. Unter dem Druck, rasch Ergebnisse zu liefern, greifen Agenten teils zu unvorhergesehenen Maßnahmen: Sie brechen aus Teststrukturen aus und dringen in das übergeordnete Netzwerk ein, um nach Lösungsansätzen zu suchen.
Trotz der Tendenz zur Übergeneralisierung zeichnet sich wieder eine Bewegung hin zur gezielten Spezialisierung ab. Unternehmen setzen zunehmend auf KI-Systeme, die speziell für ihre Anwendungsbereiche trainiert werden. Typische Einsatzfelder sind Buchhaltung oder Robotik, wo Spezialmodelle ermitteln, wie viele Bauteile wie Schrauben und Muttern eine Maschine benötigt, und Anweisungen an Bots weitergeben. Auch in Automobilen sowie in autonom fahrenden Taxiflotten, wie Waymo-Fahrzeugen in den USA und Europa, kommen solche spezialisierten KIs zum Einsatz.
Welche Konsequenzen ergeben sich aus der KI-Evolution für die digitale Struktur und die Suchmaschinenoptimierung?
Angesichts der Fortschritte bei Sprachmodellen stellt sich regelmäßig die Frage, ob die klassische Suchmaschinenoptimierung (SEO) ausgedient hat. Die Antwort darauf lautet eindeutig Nein. Sprachmodelle arbeiten nach wie vor so, dass sie auf Prompts reagieren und Texte mithilfe von Vektoren analysieren – verarbeiten können sie jedoch nur jene Inhalte, die für sie sichtbar und zugänglich sind.
Für Webseitenbetreiber bedeutet dies, dass technische Basisarbeit essenziell bleibt. Eine Website muss von Sprachmodellen problemlos gecrawlt und indexiert werden können. Zudem sind eine klare Seitenstruktur sowie verständliche Sprache von zentraler Bedeutung. Um der Vektorisierung von KIs entgegenzukommen, haben sich strukturierte Frage-Antwort-Formate (FAQ-Schemata) sowie Aufzählungslisten als besonders wirkungsvoll erwiesen. Auch das Verbleiben im klaren Themenkontext ist notwendig, damit KI-Modelle Zusammenhänge ohne Abschweifungen erfassen können.
Ein aktuelles Beispiel zeigt die Relevanz strukturierter Daten: Das moderne Modell GPT-6 Astra greift bei Suchanfragen direkt auf Produktdatenbanken von Google Shopping zurück. Daten, die über XML-Feeds oder JSON-Formate strukturiert in diese Datenbanken fließen, beeinflussen somit unmittelbar die Suchergebnisse des Sprachmodells.
Dies gewinnt vor allem im Hinblick auf den aufkommenden Agentic E-Commerce an Bedeutung, bei dem autonome KI-Agenten stellvertretend für Nutzer einkaufen. Damit solche Agenten reibungslos agieren können, müssen Webinhalte technisch sauber ausgezeichnet sein. Elemente wie Schaltflächen müssen im Code als echte Buttons definiert sein und Formularfelder zwingend in korrekten HTML-Formular-Tags liegen, anstatt sie bloß per JavaScript zusammenzufügen. Ein barrierefreies und semantisch korrektes Design bildet somit das Fundament dafür, dass KI-Agenten digitale Angebote verstehen und bedienen können.
Fazit – Die Geschichte der Künstlichen Intelligenz
Zusammenfassend zeigt die Geschichte der Künstlichen Intelligenz eine Entwicklung von starren, linearen Systemen der 1950er-Jahre hin zu hochkomplexen, orchestrierten Sprachmodellen und autonomen Agenten. Der entscheidende Durchbruch durch moderne Attention-Architekturen ermöglichte es KIs, sprachliche Zusammenhänge vektoriell zu erfassen, woraus sowohl spezialisierte Unternehmenslösungen als auch vielseitige Alltagsassistenten hervorgingen. Für die digitale Zukunft bleibt eine saubere technische und semantische Aufbereitung von Daten die grundlegende Voraussetzung, damit Mensch und Künstliche Intelligenz barrierefrei miteinander interagieren können.
Die stetige Annäherung an eine ausgereifte Superintelligenz macht deutlich, dass wir erst am Anfang einer grundlegenden Transformation unserer Informationswelt stehen.

Über den Autor
Jens Mönning ist ein Experte im Bereich Online-Marketing und Suchmaschinenoptimierung (SEO & GEO) und arbeitet seit 2022 als SEO-Manager bei der MADMEN Onlinemarketing GmbH. Er beschäftigt sich seit 1999 mit Suchmaschinenoptimierung und Onlinemarketing und betreut Kunden aus ganz Deutschland im Bereich SEO und GEO.

