
 8 min
Codename Labrador: Wie der eigene Suchindex von ChatGPT funktioniert und was das für SEO & GEO bedeutet
Mit der Entwicklung eines eigenen Suchindex unter dem Codenamen Labrador hat OpenAI einen entscheidenden Schritt vollzogen, um die eigene Unabhängigkeit von externen Suchanbietern zu stärken und Antworten effizienter bereitzustellen. Die Analyse dieses Index offenbart grundlegende Veränderungen in der Erfassung von Webinhalten und zeigt auf, welche technischen Anpassungen für eine nachhaltige Sichtbarkeit in KI-Systemen erforderlich sind.
Sie sehen gerade einen Platzhalterinhalt von Standard. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf den Button unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.

Das Wichtigste in Kürze
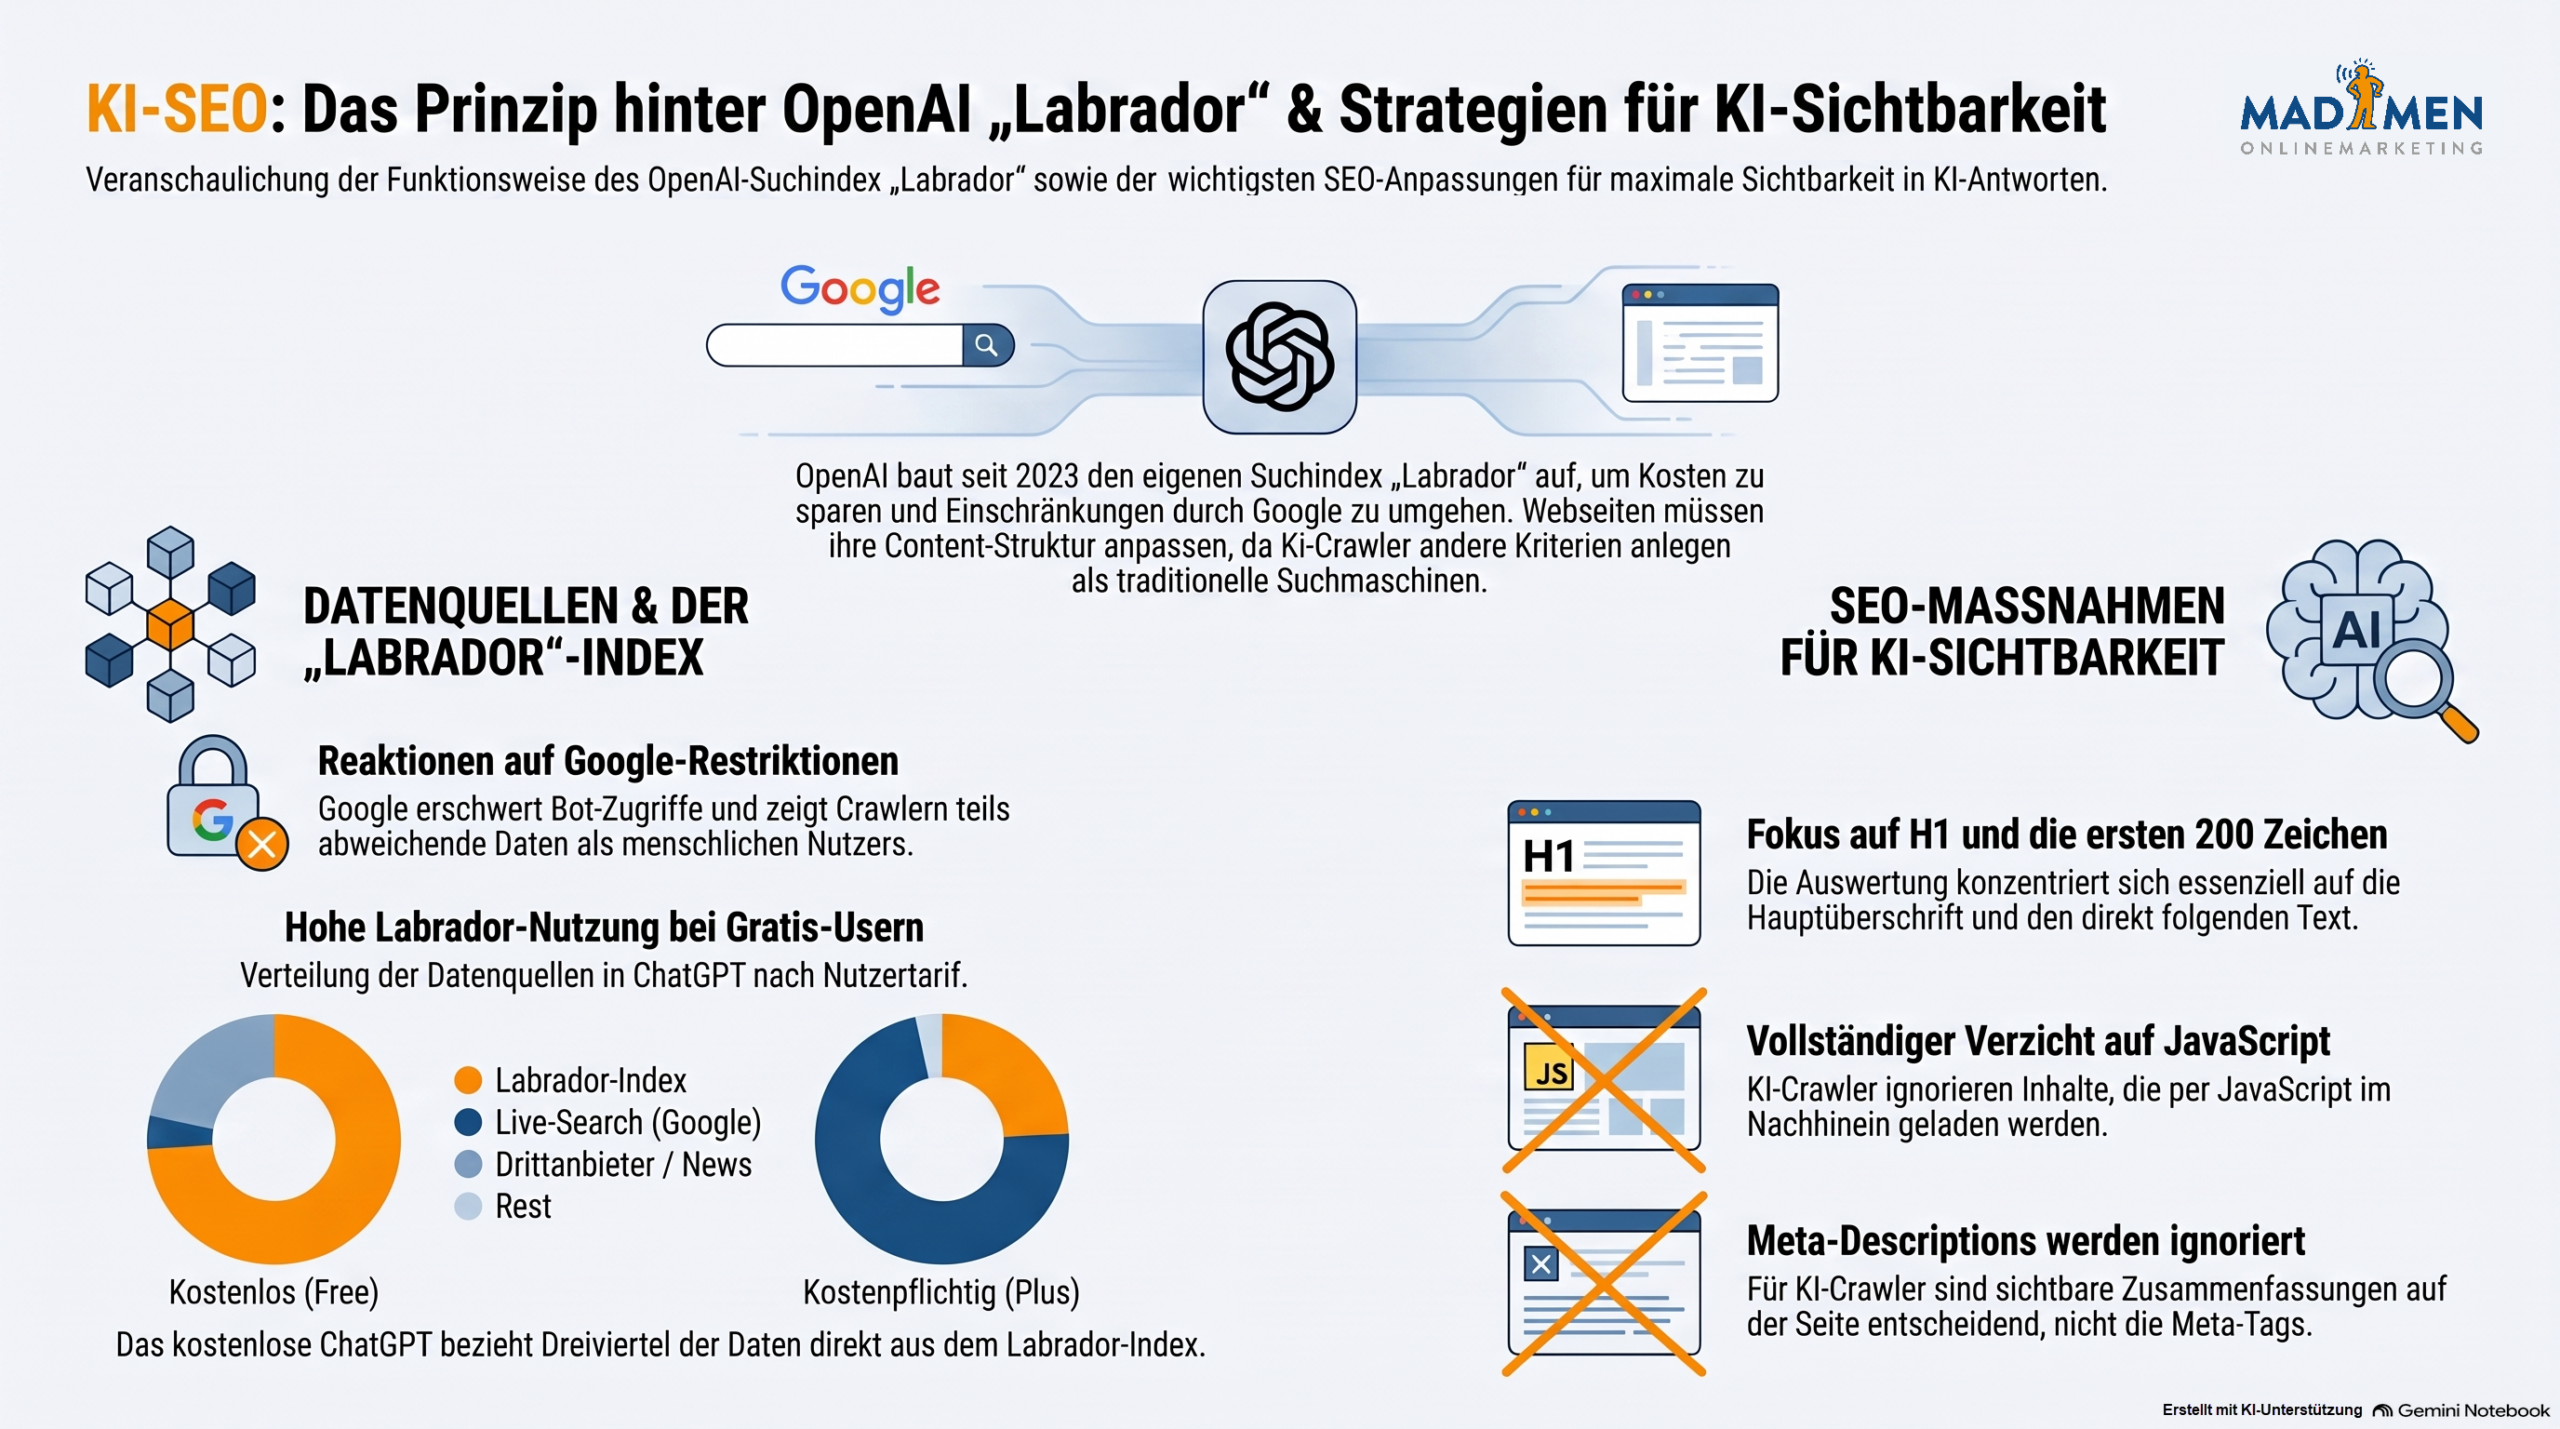
- Eigener Suchindex seit 2023: OpenAI baut mit dem Codenamen Labrador einen eigenen Index auf, um Betriebskosten zu senken und die Antwortgeschwindigkeit zu erhöhen.
- Unterschiede nach Nutzungsmodell: Die kostenfreie ChatGPT-Version greift zu rund 74 bis 75 Prozent auf den internen Labrador-Index zurück, während die kostenpflichtige Version überwiegend Live-Daten aus der Google-Suche nutzt.
- Fokus bei der Inhaltserfassung: Der Index wertet vorrangig den Seitentitel, die H1-Hauptüberschrift und die darauffolgenden ca. 200 Zeichen aus.
- Keine Unterstützung für JavaScript: Dynamisch nachgeladene Inhalte, Klappelemente oder Skripte werden vom KI-Crawler nicht erfasst; auch Meta-Descriptions bleiben unberücksichtigt.
- Verfälschte SERPs durch Bot-Erkennung: Google zeigt KI-Scrapern derzeit andere Suchergebnisse als menschlichen Nutzern, was zu Schwierigkeiten bei der Datenerfassung bei klassischen SEO-Tools führt.
Was verbirgt sich hinter dem Codenamen Labrador und wie ist der Suchindex entstanden?
Hinter der Bezeichnung Labrador verbirgt sich das Projekt eines eigenen Suchindex von OpenAI, der bereits seit dem Jahr 2023 im Hintergrund aufgebaut wird. Sichtbar wurden konkrete Hinweise auf diesen Index über Server-Event-Protokolle von ChatGPT, in denen ein Parameter zur Bestimmung der Datenquelle kurzzeitig Werte wie SERP, Drittanbieter-Scraper und Labrador aufwies.
Die strategische Entscheidung zur Entwicklung einer eigenen Datenbasis gründet auf mehreren Faktoren. Zu Beginn stützten sich die Antwortgenerierungen von ChatGPT primär auf die Suchergebnisse von Bing. Allerdings erwies sich die Datenqualität phasenweise als unzureichend für die hohen Anforderungen komplexer KI-Anfragen. Der Versuch, stattdessen in großem Stil auf Google-Suchergebnisse zuzugreifen, stieß schnell an Grenzen: Google verweigert direkte Datenpartnerschaften, da die eigenen Suchdaten das zentrale Betriebskapital darstellen. Zudem erschwert Google das automatisierte Auslesen von Webseiten durch technische Hürden wie spezielle Weiterleitungs-URLs (GoTo-URLs), was die Scraping-Kosten für externe Anbieter vervielfacht.
Ein eigener Suchindex fungiert in diesem Szenario als effizienter Zwischenspeicher. Anstatt bei jeder einzelnen Nutzeranfrage einen zeit- und kostenintensiven Crawling-Prozess im Live-Web zu starten, kann ChatGPT auf intern vorgehaltene Informationen zurückgreifen. Dies reduziert die Rechenkosten drastisch und verbessert gleichzeitig die Antwortzeiten für die Anwender.
Wie unterscheidet sich die Nutzung des Suchindex zwischen der kostenlosen und kostenpflichtigen ChatGPT-Version?
Bei der Beantwortung von Anfragen unterscheidet ChatGPT strikt zwischen kostenfreien Konten und kostenpflichtigen Abonnements. Diese Differenzierung spiegelt die dahinterliegende Kostenstruktur wider.
In der kostenlosen Variante stammen durchschnittlich 74 bis 75 Prozent aller bereitgestellten Informationen direkt aus dem hauseigenen Labrador-Index. Lediglich rund 3 Prozent der Anfragen greifen auf ein aktives Live-Search-Grounding bei Google zurück. Die verbleibenden etwa 22 Prozent werden über etablierte Drittanbieterkanäle, Nachrichtenseiten und nutzergenerierte Inhaltsplattformen abgedeckt. Für den Anbieter bedeutet diese Verteilung eine massive Reduzierung laufender API- und Scraping-Kosten im Massengeschäft.
Bei den kostenpflichtigen Abonnements dreht sich dieses Verhältnis nahezu komplett um. Hier basieren etwa 75 Prozent der Antworten auf aktuellen Live-Daten aus der Google-Suche. Der interne Labrador-Index kommt in diesem Segment nur noch zu rund 24 Prozent zum Einsatz. Zahlende Abonnenten erhalten somit eine deutlich höhere Datenaktualität durch Echtzeit-Prüfungen, während kostenlose Anfragen primär über den bestehenden Cache verarbeitet werden.
Welche Inhalte einer Webseite liest der Suchindex von ChatGPT tatsächlich aus?
Die Inhaltsanalyse durch den ChatGPT-Crawler unterscheidet sich teilweise von der Arbeitsweise traditioneller Suchmaschinen-Crawler. Anstatt eine gesamte Seite in all ihren Facetten und Skriptstrukturen zu verarbeiten, konzentriert sich der Algorithmus auf bestimmte Textelemente.
Die wichtigsten Signalebenen bilden ein präziser und aussagekräftiger Seitentitel (Title-Tag) in Kombination mit der primären Hauptüberschrift (H1). Entscheidend für die inhaltliche Bewertung sind vor allem die ersten circa 200 Zeichen, die unmittelbar auf die H1-Überschrift folgen. Ergänzend werden strukturierte Daten ausgewertet, sofern diese sauber im Quellcode hinterlegt sind.
Eine bemerkenswerte Erkenntnis betrifft die Meta-Description: Diese wird vom Labrador-Index vollständig ignoriert.
Ebenfalls von zentraler Bedeutung ist die technische Einschränkung bezüglich JavaScript. Der Crawler von OpenAI unterstützt kein JavaScript. Inhalte, die erst durch Skripte dynamisch geladen, über Interaktionen wie Klappelemente (Akkordeons) sichtbar gemacht oder in Karussell-Gleitern dargestellt werden, bleiben für den Suchindex unsichtbar. Was beim initialen Ladevorgang des HTML-Codes nicht direkt vorhanden ist, existiert für die KI-Inhaltserfassung nicht.
Wie müssen Webseiten aufgebaut sein, um eine optimale Sichtbarkeit in der KI-Suche zu erreichen?
Aus den technischen Rahmenbedingungen des Labrador-Index leiten sich konkrete Anforderungen an die Gestaltung und Strukturierung von Webseiten ab. Ziel einer zeitgemäßen Optimierung ist es, dem Crawler die Erfassung relevanter Kerninformationen so einfach wie möglich zu machen.
Im sichtbaren Bereich ohne Scrollen („Above the Fold“) sollten grundlegende Marken- und Kontaktinformationen klar erkennbar sein. Dazu gehören neben dem Logo gut sichtbare Kontaktdaten wie Telefonnummer oder E-Mail-Adresse.
Für den redaktionellen Aufbau empfiehlt sich ein klassisches Editorial-Format, das nach dem Prinzip der umgekehrten Pyramide aufgebaut ist. Unterhalb einer prägnanten H1-Hauptüberschrift sollte der erste Textabsatz die zentrale Fragestellung oder Definition in zwei bis drei klaren Sätzen auf den Punkt bringen. Erst nach dieser verdichteten Zusammenfassung folgt der ausführliche Haupttext mit vertiefenden Analysen, Detailaspekten und Hintergrundinformationen.
Barrierefreiheit und einfache HTML-Strukturen sind auch weiterhin obligatorisch. Der Verzicht auf verschachtelte Skripte und visuelle Spielereien zugunsten von direkt lesbarem Klartext stellt sicher, dass sowohl menschliche Leser als auch automatisierte KI-Systeme die wesentlichen Botschaften ohne Erfassungsverluste aufnehmen können.
Warum verfälschen geänderte Google-Suchergebnisse für Bots die Daten von SEO-Tools?
Ein weiteres Phänomen, das die Analyse der Suchlandschaft derzeit stark beeinflusst, ist das veränderte Auslieferungsverhalten von Google gegenüber automatisierten Systemen. Untersuchungsergebnisse einer Studie von Noozle belegen, dass Google KI-Bots und Web-Scrapern teils völlig andere Suchergebnis-Seiten (SERPs) anzeigt als menschlichen Nutzern.
Im Vergleich zu den für Menschen ausgespielten Suchergebnisse, weichen die an Bots übermittelten Ergebnisse teilweise drastisch ab. Für die Anbieter professioneller SEO-Werkzeuge wie Sistrix oder Data for SEO führt dieses Auslieferungsverhalten zu erheblichen Herausforderungen. Da diese Werkzeuge automatisierte Abfragen zur Datenaggregierung nutzen müssen, erfassen sie stellenweise verfälschte Positionsdaten. Um zuverlässige Informationen zu liefern, müssen Datenanbieter mehrfache Verifizierungsdurchläufe starten, was die Betriebskosten massiv erhöht. Schwankungen in Ranking-Monitoren sollten daher mit Bedacht bewertet werden. Als verlässliche Datenquelle zur Überwachung der tatsächlichen organischen Performance bleibt die Google Search Console unverzichtbar, da diese direkt auf den realen Impressionen und Klicks menschlicher Nutzer basiert.
Welchen Stellenwert haben klassische Ranking-Kennzahlen in der KI-basierten Suche?
Die Transformation der Suchmaschinenlandschaft erfordert auch ein Umdenken bei den etablierten Erfolgsmessgrößen im Onlinemarketing. Traditionelle Leistungskennzahlen wie feste Platzierungen („Ranking Position 1“) oder ein monatliches Suchvolumen lassen sich nicht direkt auf dialogorientierte KI-Systeme übertragen.
In Sprachmodellen wie ChatGPT existieren keine statischen Trefferlisten, auf denen feste Positionen überwacht werden könnten. Die Ausspielung von Informationen erfolgt dynamisch, kontextabhängig und stark individuell geprägt durch die jeweilige Fragestellung des Nutzers. Zwar gibt es spezialisierte Anwendungsansätze zur Erfassung von Markennennungen in KI-Suchen, jedoch fehlen bisher offizielle Analysewerkzeuge der Anbieter. Ein Äquivalent zu den Webmaster-Tools klassischer Suchmaschinen, das transparente Einblicke in Einblendungshäufigkeiten und Themenkontexte innerhalb von ChatGPT gewährt, ist derzeit noch Zukunftsmusik.
Fazit – ChatGPT hat einen Suchindex
Die Einführung des internen Suchindex Labrador bei ChatGPT markiert einen Wendepunkt in der Inhaltsverarbeitung moderner Sprachmodelle und verdeutlicht den klaren Trend zu eigenständigen Datenökosystemen. Für die digitale Informationsaufbereitung rückt eine saubere, barrierefreie HTML-Struktur mit prägnanten Kernaussagen direkt zu Beginn der Abschnitte in den Fokus.
Unternehmen und Inhaltsanbieter, die auf gut strukturierte Texte und direkte Antworten setzen, schaffen die beste Grundlage, um sowohl in klassischen Suchmaschinen als auch in KI-basierten Antwortsystemen nachhaltig auffindbar zu bleiben.

Über den Autor
Jens Mönning ist ein Experte im Bereich Online-Marketing und Suchmaschinenoptimierung (SEO & GEO) und arbeitet seit 2022 als SEO-Manager bei der MADMEN Onlinemarketing GmbH. Er beschäftigt sich seit 1999 mit Suchmaschinenoptimierung und Onlinemarketing und betreut Kunden aus ganz Deutschland im Bereich SEO und GEO.

