
 6 min
Labrador-Index: Aufbau, Verticals und Cache-Logik
Labrador ist OpenAIs eigener Suchindex für ChatGPT: kein einzelner Index, sondern eine Familie spezialisierter Teilindizes mit Lese-Cache, Markdown-Speicherung und Ergebnissen aus drei Elementen.
Was der Labrador-Index ist
Labrador ist OpenAIs internes Retrieval-System und damit der hauseigene Suchindex von ChatGPT. OpenAI betreibt ihn seit mindestens 2023 mit dem Ziel, ChatGPT unabhängiger von externen Suchmaschinen wie Google und Bing zu machen. Die Datenbestände baut das Unternehmen über eigene Crawler auf, insbesondere über den OAI-SearchBot und den GPTBot.
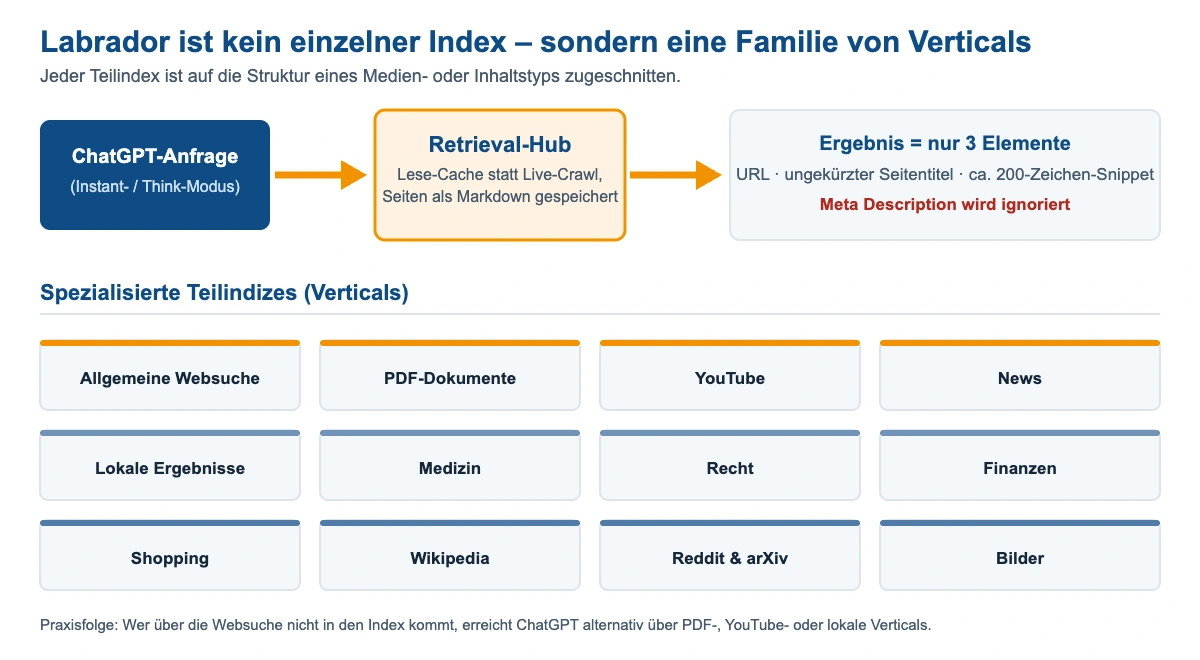
Entscheidend für die Optimierung ist die Architektur: Labrador ist kein einzelner, monolithischer Index, sondern eine Familie spezialisierter Teilindizes – sogenannter Verticals. Jeder Bereich ist auf die Struktur eines bestimmten Medien- oder Inhaltstyps zugeschnitten und wird getrennt befüllt.
Die Verticals im Überblick
Labrador greift neben der allgemeinen Websuche auf eigene Teilindizes für einzelne Formate und Themenfelder zurück. Diese Trennung ist der Grund dafür, dass ein Unternehmen über einen Kanal bereits zitiert werden kann, während seine Hauptwebsite im allgemeinen Web-Index noch fehlt.
| Vertical | Inhaltstyp | Typischer Anwendungsfall |
|---|---|---|
| Allgemeine Websuche | HTML-Seiten | Leistungs-, Ratgeber- und Money-Pages |
| Dokumente auf der eigenen Domain | Whitepaper, Leitfäden, technische Ratgeber | |
| YouTube | Videos mit Transkript | Erklärformate, Produktdemos, Fachvorträge |
| News | Aktuelle Meldungen | Presse- und Branchennachrichten |
| Lokale Ergebnisse | Standortprofile | Google Unternehmensprofil, Yelp, TripAdvisor |
| Medizin, Recht, Finanzen | Fachliche Themensektoren | Praxen, Kanzleien, Makler, Beratung |
| Shopping | Produktdaten | E-Commerce und Handel |
| Wikipedia, Reddit, arXiv | Externe Wissensquellen | Entitäts- und Faktenabgleich |
| Bilder | Bildmaterial mit Textkontext | Visuelle Ergänzung von Antworten |
Welches Vertical für ein Unternehmen den schnellsten Weg in den Index darstellt, hängt vom Geschäftsmodell ab. Eine Einordnung nach Branchen findet sich auf der Seite Branchenvorteile im Labrador-Index.
Lese-Cache statt Live-Crawl
Labrador durchsucht das Web bei einer Nutzeranfrage nicht in Echtzeit. Stattdessen speichert das System abgerufene Seiten vollständig in einem eigenen Lese-Cache und konvertiert die Inhalte dabei von HTML in Markdown. Dieser Aufbau ermöglicht die kurzen Antwortzeiten, die Nutzer von ChatGPT erwarten.
Zwei praktische Folgen der Cache-Architektur
- Markdown-Konvertierung: Bei der Umwandlung bleiben strukturierende Elemente wie Überschriften, Listen und Alt-Texte erhalten. Reine Design- und Layout-Elemente verlieren dagegen ihre visuelle Wirkung und stehen als Text im Fließtext.
- Feste Snippets: Was beim Indexieren als Snippet erfasst wurde, wird Beobachtungen zufolge nicht dynamisch nachgeführt. Eine Textänderung auf der Seite wirkt erst, wenn der Crawler die Seite erneut abruft.
Wie Labrador Webseiten verarbeitet
Gegenüber klassischen Suchmaschinen gelten eigene Regeln. Sie sind der Kern jeder GEO-Maßnahme, weil sie festlegen, welcher Teil einer Seite beim Modell überhaupt ankommt.
- Fokus auf die ersten 200 Zeichen nach der H1: Das Snippet entsteht aus dem Textausschnitt direkt unter der Hauptüberschrift. Details dazu auf der Seite 200-Zeichen-Regel.
- Ungekürzte Titel: Während Google Titel häufig nach rund 60 Zeichen abschneidet, übergibt Labrador den vollständigen Seitentitel an das Modell.
- Meta Description ohne Wirkung: Die klassische Description wird für das Snippet nicht herangezogen.
- Kein JavaScript: Dynamisch nachgeladene Inhalte fehlen im Index vollständig.
- Maximal 4 MB: Seiten oberhalb dieser Gesamtgröße werden abgelehnt.
- Alt-Texte bleiben erhalten: Bei der Markdown-Konvertierung überleben sie als Textinformation.
Ein Ergebnis besteht aus nur drei Elementen
Ein Suchergebnis im Labrador-Index umfasst ausschließlich die URL, den ungekürzten Seitentitel und ein rund 200 Zeichen langes Snippet. Diese drei Signale sind alles, was das Sprachmodell im kostenlosen Modus über eine Seite erfährt, bevor es entscheidet, ob es sie als Quelle heranzieht.
Daraus folgt die Priorisierung: Titel und erste 200 Zeichen sind keine kosmetischen Details, sondern zwei von drei verfügbaren Informationskanälen. Wer sie unbearbeitet lässt, überlässt dem Zufall, wie ChatGPT das eigene Angebot beschreibt.
Update-Logik und Crawl-Frequenz
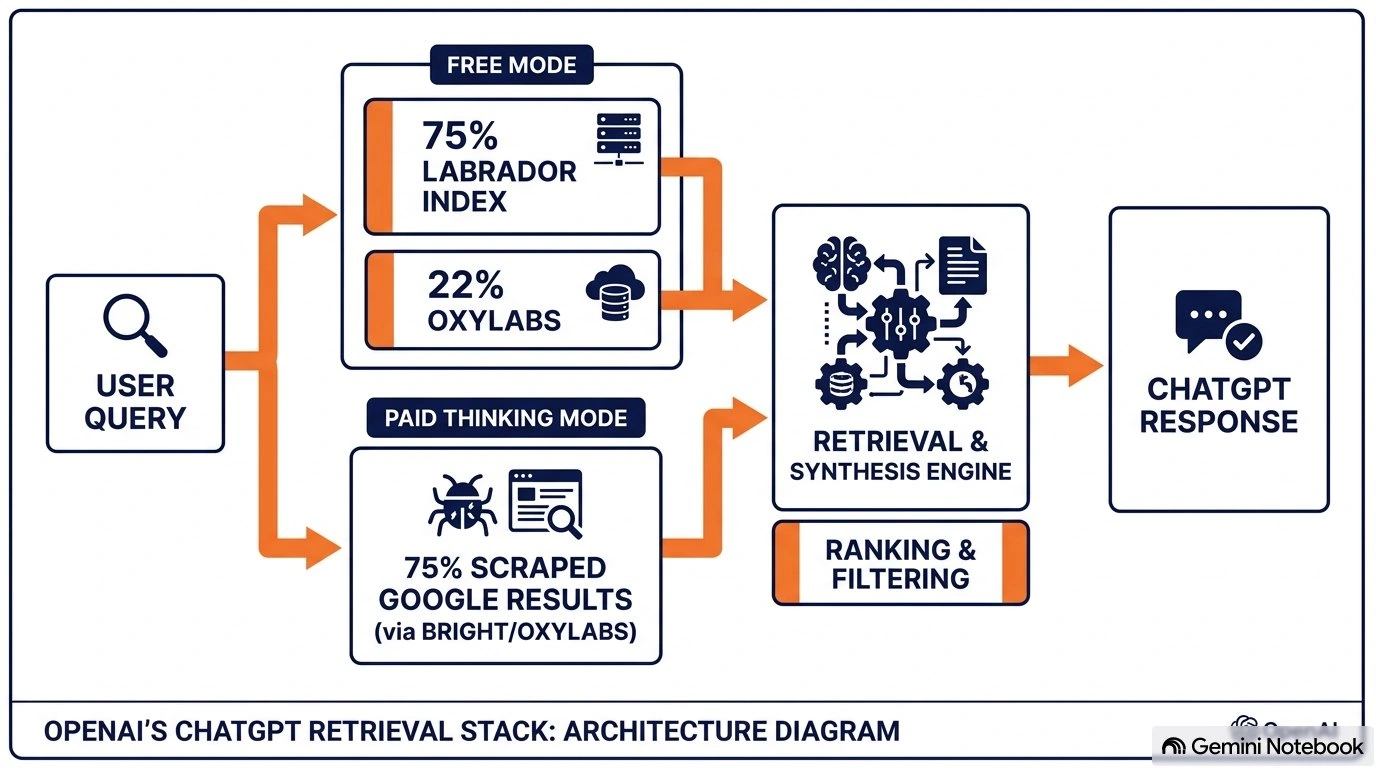
Feste Aktualisierungsintervalle für einzelne Seiten oder den Gesamtindex sind nicht dokumentiert. Belegt ist dagegen, dass OpenAI kontinuierlich crawlt: In Analysen wurden rund 35.000 Abrufe pro Stunde gemessen. Neue Inhalte gelangen also grundsätzlich fortlaufend in den Bestand.
Weil einmal gespeicherte Snippets nicht dynamisch aktualisiert werden, gilt für die Praxis: Änderungen am H1-Bereich sollten in einem Zug erfolgen und nicht in vielen kleinen Schritten. Je vollständiger eine Seite beim nächsten Abruf vorbereitet ist, desto besser fällt das dauerhaft gespeicherte Snippet aus.
Konsequenzen für die Optimierung
- Der Textbereich unter der H1 hat Priorität – er ist die einzige Textquelle für das Snippet.
- Der Titel trägt den Kontext, den das 200-Zeichen-Fenster nicht mehr aufnehmen kann.
- Technische Zugänglichkeit ist Voraussetzung, nicht Kür: ohne Crawler-Freigabe und HTML-Verfügbarkeit entsteht gar kein Eintrag.
- Mehrere Verticals parallel bespielen erhöht die Chance, überhaupt als Quelle verfügbar zu sein.
Häufige Fragen zu den Laprador-Index-Grundlagen
Seit wann betreibt OpenAI den Labrador-Index?
Seit mindestens 2023. Ziel ist es, ChatGPT schrittweise unabhängig von externen Suchmaschinen zu machen und eigene Datenbestände über Crawler wie den OAI-SearchBot und den GPTBot aufzubauen.
Führt Labrador bei jeder Anfrage einen Live-Crawl durch?
Nein. Labrador greift auf einen eigenen Lese-Cache zurück. Abgerufene Seiten werden vollständig gespeichert und von HTML in Markdown konvertiert. Änderungen wirken deshalb erst beim nächsten Crawl.
Aus welchen Elementen besteht ein Labrador-Suchergebnis?
Aus genau drei Elementen: URL, ungekürzter Seitentitel und ein rund 200 Zeichen langes Snippet aus dem Fließtext unter der H1. Die Meta Description wird nicht herangezogen.
Wie groß ist die Überlappung mit Google und Bing?
Die Ergebnisse überschneiden sich zu rund 33 Prozent mit Google und nur zu etwa 8 Prozent mit Bing. Zwei Drittel der in ChatGPT genutzten Quellen unterscheiden sich damit von den Google-Ergebnissen.
Ist Ihre Domain im Labrador-Index vertreten?
Wir prüfen Ihre wichtigsten Seiten auf Crawler-Freigabe, Snippet-Qualität und Vertical-Abdeckung.
Beratung anfragenÜber den Autor
 Jens Mönning ist ein Experte im Bereich Online-Marketing und Suchmaschinenoptimierung (SEO & GEO) und arbeitet seit 2022 als SEO-Manager bei der MADMEN Onlinemarketing GmbH. Er beschäftigt sich seit 1999 mit Suchmaschinenoptimierung und Onlinemarketing und betreut Kunden aus ganz Deutschland im Bereich SEO und GEO.
