
 4 min
Entitätslücken schließen mit Schema.org
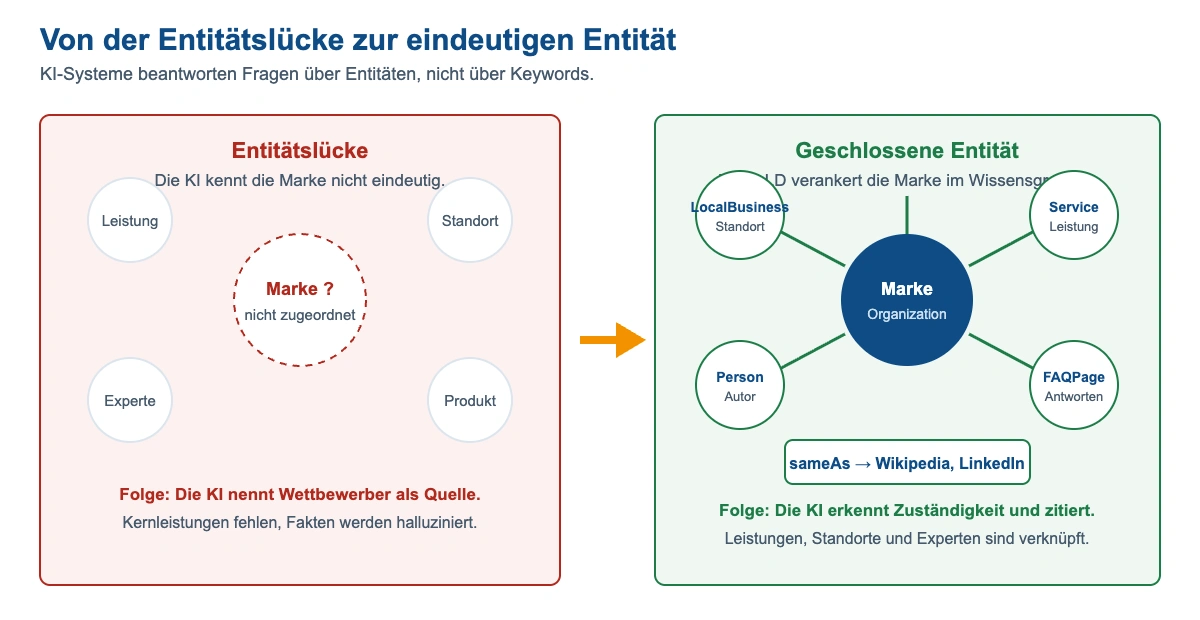
Eine Entitätslücke entsteht, wenn KI-Systeme eine Marke nicht eindeutig zuordnen können. Strukturierte Daten in JSON-LD liefern die Infrastruktur, um sie im Wissensgraphen zu verankern.
Was eine Entitätslücke ist
Eine Entitätslücke (Entity Gap) entsteht, wenn KI-Systeme und Wissensgraphen eine Marke, ein Produkt, eine Person oder ein Konzept nicht eindeutig verstehen, falsch klassifizieren oder wichtige Verknüpfungen zu deren Kernkompetenzen fehlen. Da Sprachmodelle Anfragen nicht primär über einzelne Schlüsselwörter, sondern über das Verständnis von Entitäten verarbeiten, führt eine solche Lücke dazu, dass ein Unternehmen bei einschlägigen Fragen schlicht nicht genannt wird.
Schritt 1: KI-Entitäts-Fußabdruck analysieren
Gezielte Abfragen in ChatGPT, Gemini, Perplexity und Copilot zeigen, wie die Systeme ein Unternehmen aktuell einordnen. Geeignet sind Prompts wie „Welche Leistungen bietet Unternehmen X an?“ oder „Wer sind die führenden Anbieter für [Fachgebiet] in [Region]?“.
Worauf bei den Antworten zu achten ist
- Nennt das Modell falsche Fakten oder erfundene Leistungen?
- Fehlen zentrale Kernleistungen vollständig?
- Wird die Marke bei Fragen zum eigenen Fachgebiet gar nicht erwähnt?
- Werden stattdessen durchgängig dieselben Wettbewerber genannt?
Schritt 2: Strukturierte Daten technisch prüfen
Im zweiten Schritt wird geprüft, ob für Unternehmen, Produkte, Standorte und Autoren überhaupt strukturierte Daten in JSON-LD hinterlegt sind. Eine Entitätslücke liegt vor, wenn Auszeichnungen wie Organization, LocalBusiness, Product, Person oder sameAs-Verweise fehlen. Ohne dieses Auszeichnungssystem fehlt den KI-Crawlern die Infrastruktur zur Einordnung in ihren Wissensgraphen.
Schritt 3: Verzeichnisse und Spezialindizes abgleichen
Unternehmensdaten – Name, Adresse, Ansprechpartner, Leistungen – müssen auf allen Plattformen identisch hinterlegt sein: im Google Unternehmensprofil, bei Yelp, TripAdvisor und in relevanten Branchenregistern. Abweichungen erzeugen konkurrierende Versionen derselben Entität.
Zusätzlich entsteht eine Lücke, wenn eine Marke in den Spezialindizes nicht vertreten ist. Weil Labrador getrennte Verticals für PDFs, YouTube, News und lokale Profile nutzt, fehlt dort ohne eigene Fachinhalte jede Spur des Unternehmens.
Schritt 4: E-E-A-T- und Autoritätssignale vergleichen
Fehlen Fachmedien-Zitationen, echte Fallstudien, Zertifizierungen oder Autorenprofile, stufen KI-Systeme eine Entität als weniger autoritativ ein und bevorzugen etabliertere Mitbewerber. Der Abgleich mit den drei sichtbarsten Wettbewerbern zeigt schnell, welche Signale fehlen. Mehr dazu auf der Seite E-E-A-T für die KI-Suche.
Markup-Vorlage in JSON-LD
Die folgende Vorlage verknüpft Unternehmen, Standort, Leistung und Autor zu einem zusammenhängenden Entitätsgraphen. Sie gehört in den <head> der jeweiligen Seite und muss inhaltlich mit den sichtbaren Angaben übereinstimmen.
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "LocalBusiness",
      "@id": "https://www.beispiel.de/#organization",
      "name": "Musterbetrieb GmbH",
      "description": "Dachdeckermeisterbetrieb in Nürnberg für Eindeckung, Flachdachsanierung und Sturmschaden-Reparatur.",
      "url": "https://www.beispiel.de/",
      "telephone": "+49 911 1234567",
      "address": {
        "@type": "PostalAddress",
        "streetAddress": "Musterstraße 1",
        "postalCode": "90402",
        "addressLocality": "Nürnberg",
        "addressCountry": "DE"
      },
      "areaServed": "Nürnberg und Umgebung",
      "sameAs": [
        "https://www.linkedin.com/company/musterbetrieb",
        "https://de.wikipedia.org/wiki/…"
      ]
    },
    {
      "@type": "Service",
      "name": "Flachdachsanierung",
      "serviceType": "Dachdeckerarbeiten",
      "provider": { "@id": "https://www.beispiel.de/#organization" },
      "areaServed": "Nürnberg"
    },
    {
      "@type": "Person",
      "name": "Vorname Nachname",
      "jobTitle": "Dachdeckermeister",
      "worksFor": { "@id": "https://www.beispiel.de/#organization" }
    }
  ]
}
</script>
Vier Regeln für belastbares Markup
- Nur auszeichnen, was sichtbar ist. Markup und Seiteninhalt müssen übereinstimmen.
- @id-Referenzen nutzen, damit Leistungen und Personen eindeutig auf das Unternehmen verweisen.
- sameAs konsequent pflegen – jeder externe Profil-Link stärkt die Zuordnung.
- Nach jedem Relaunch neu validieren, etwa im Google Rich-Results-Test und im Schema-Markup-Validator.
Häufige Fragen
Was ist eine Entitätslücke?
Sie entsteht, wenn KI-Systeme und Wissensgraphen eine Marke, ein Produkt oder eine Person nicht eindeutig verstehen, falsch klassifizieren oder Verknüpfungen zu deren Kernkompetenzen fehlen. Die Folge: keine Nennung bei relevanten Anfragen.
Wie erkenne ich eine Entitätslücke?
Über vier Prüfschritte: Prompt-Testing in mehreren KI-Systemen, technische Prüfung des Schema.org-Markups, Abgleich von Verzeichnissen und Spezialindizes sowie Vergleich der E-E-A-T-Signale mit dem Wettbewerb.
Welche Schema.org-Typen sind besonders wichtig?
Organization beziehungsweise LocalBusiness für das Unternehmen, Service oder Product für Leistungen, Person für Autoren, FAQPage für Fragen und Antworten sowie sameAs-Verweise auf externe Profile.
Wirkt Schema.org direkt auf das Labrador-Snippet?
Nein. Das Snippet entsteht aus dem Fließtext unter der H1. Strukturierte Daten wirken auf die Ebene darüber: Sie helfen KI-Systemen, die Marke als Entität zu erkennen und ihr Themen und Leistungen zuzuordnen.
Entitäts-Check für Ihre Marke
Wir testen, wie KI-Systeme Ihr Unternehmen heute beschreiben, und entwerfen das passende JSON-LD-Markup.
Beratung anfragen